
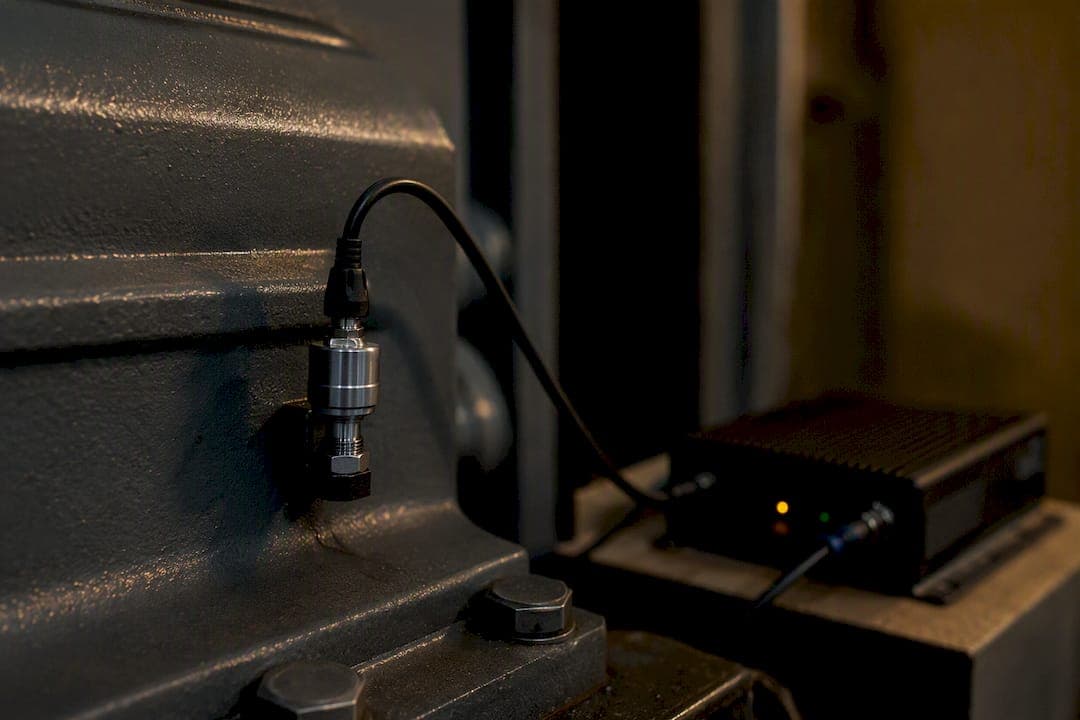
Predictive maintenance IoT (utrzymanie predykcyjne oparte na internecie rzeczy) to system, w którym czujniki zbierają dane o pracy maszyny, a modele uczenia maszynowego analizują je i przewidują awarię z wyprzedzeniem. Największa korzyść to redukcja nieplanowanych przestojów, które kosztują najwięcej i najbardziej dezorganizują produkcję. Jeśli zaczynasz, nie kupuj czujników do całej fabryki. Zrób pilota na jednym krytycznym zasobie, którego przestój najbardziej boli finansowo.
Krótko mówiąc:
- Skuteczność predictive maintenance opiera się na dokładnym doborze czujników, a nie ilości zainstalowanych urządzeń, co pozwala unikać zbędnych danych.
- Modele adaptacyjne uczą się na bieżąco na potwierdzonych danych, minimalizując fałszywe alarmy i zwiększając precyzję prognozowania awarii.
- Wdrożenie powinno się zacząć od pilota na jednym krytycznym zasobie, a nie od pełnej instalacji na całym zakładzie.
- Kluczowe jest połączenie warstwy edge z systemami CMMS i MES, aby informacje o stanie maszyny przekładały się na konkretne zlecenia serwisowe.
- Brak systematycznej informacji o przyczynach awarii (ground truth) znacznie obniża skuteczność modeli predictive maintenance.
Spis treści
- Jak działa predictive maintenance krok po kroku
- Kluczowe komponenty: czujniki, bramy edge i standardy komunikacji
- Modele ML i algorytmy: adaptacyjne, ensemble i predykcja RUL
- Architektura Edge–Cloud i integracja z CMMS, MES i SCADA
- Plan wdrożenia: od audytu przez pilota do skalowania
- Wyzwania wdrożeniowe: ground truth, fałszywe alarmy i cyberbezpieczeństwo
- KPI i ROI: jak mierzyć sukces predykcyjnego utrzymania
- Case study Synaptix: jak Studio-lokhit wdrożyło monitoring stanu maszyn
- Perspektywa autora: co naprawdę decyduje o sukcesie wdrożenia
- Jak Studio-lokhit wspiera wdrożenia monitoringu stanu maszyn
- Źródła
Jak działa predictive maintenance krok po kroku
Zanim jakikolwiek algorytm powie ci, że łożysko wytrzyma jeszcze dwa tygodnie, dane muszą przejść długą drogę. Zrozumienie tej drogi to podstawa, żeby ocenić, gdzie w twoim zakładzie coś może pójść nie tak.
Cały proces sprowadza się do pięciu etapów, które powtarzają się w każdej sensownej implementacji, niezależnie od branży:
- Pomiar u źródła. Czujnik (wibracji, temperatury, prądu, akustyki) rejestruje sygnał analogowy z maszyny w ustalonej częstotliwości próbkowania.
- Wstępne przetwarzanie na bramie edge. Dane trafiają do lokalnego urządzenia, które filtruje szum, wykrywa oczywiste anomalie i decyduje, co wysłać dalej.
- Transmisja do chmury lub lokalnego serwera. Tylko przetworzone, zagregowane dane (a nie cały surowy sygnał) wędrują do platformy analitycznej.
- Analiza modelem ML. Algorytm porównuje aktualny wzorzec z historycznymi danymi awarii i oblicza prawdopodobieństwo problemu lub szacuje pozostały czas życia komponentu.
- Generowanie zlecenia w CMMS. Predykcja przekształca się w konkretne zadanie dla działu utrzymania ruchu, z priorytetem i sugerowanym terminem.
Warto rozróżnić dwa zupełnie różne zadania, które często myli się pod jedną etykietą. Wykrywanie anomalii odpowiada na pytanie „czy coś jest nie tak teraz?“ i działa na zasadzie porównania z normą operacyjną. Prognoza RUL (reminding useful life, pozostały czas eksploatacji) idzie dalej i próbuje odpowiedzieć „ile jeszcze przepracuje to łożysko, zanim pęknie?“. To druga funkcja daje realną wartość biznesową, bo pozwala zaplanować przestój w wygodnym oknie serwisowym, a nie reagować w panice.
Przykład z praktyki: wzrost amplitudy wibracji w konkretnym paśmie częstotliwości często zwiastuje zużycie łożyska na 2–4 tygodnie przed katastrofalną awarią. Rosnący pobór prądu silnika przy stałym obciążeniu zdradza z kolei problemy z uzwojeniem albo tarcie mechaniczne. Żaden pojedynczy sygnał nie daje pewności. Siła predictive maintenance IoT leży w łączeniu kilku źródeł jednocześnie.
Kluczowe komponenty: czujniki, bramy edge i standardy komunikacji
Skuteczność całego systemu monitorowania stanu zależy od tego, czy dobierzesz właściwy czujnik do właściwego typu awarii, nie od tego, ile czujników zainstalujesz. Firmy inwestujące najpierw w sprzęt, a potem myślące o infrastrukturze danych, regularnie kończą z drogim zestawem, który generuje dane nieprzydatne do analizy, jak wskazuje analiza doboru czujników w środowisku fabrycznym.
Najczęściej stosowane typy czujników w diagnostyce predykcyjnej to:
- Akcelerometry wykrywają wibracje i są podstawą monitorowania łożysk, wałów i przekładni.
- Termopary i czujniki termowizyjne wychwytują przegrzewanie się komponentów elektrycznych i mechanicznych, zanim dojdzie do zwarcia lub zatarcia.
- Czujniki prądu monitorują pobór energii silników, co zdradza problemy z obciążeniem mechanicznym lub degradację izolacji.
- Mikrofony akustyczne i ultradźwiękowe wykrywają wycieki sprężonego powietrza, kawitację w pompach i wczesne stadia zużycia mechanicznego, których wibracje jeszcze nie pokazują.
Środowisko przemysłowe stawia twarde wymagania sprzętowe. Czujnik musi mieć odpowiedni stopień ochrony IP (najczęściej IP65 lub wyższy przy zapyleniu i wilgoci), odporność na zakłócenia elektromagnetyczne blisko silników i przemienników częstotliwości, oraz stabilny montaż mechaniczny, bo poluzowany czujnik generuje fałszywe alarmy szybciej niż jakakolwiek awaria maszyny.
Porada profesjonalisty: Zanim zamówisz partię czujników, przetestuj jeden egzemplarz w najbardziej wymagającej lokalizacji zakładu przez tydzień. Tanie sensory MEMS często dają niestabilny sygnał w bliskim sąsiedztwie przemienników częstotliwości, a wykryjesz to dopiero po instalacji, jeśli nie sprawdzisz tego wcześniej.
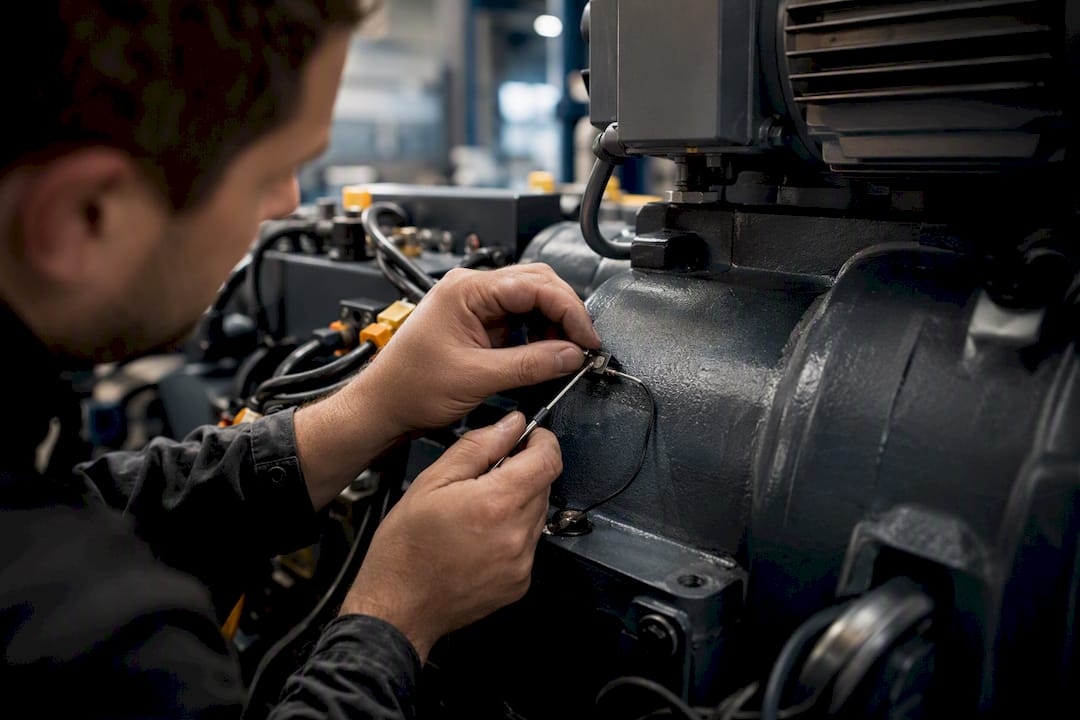
Brama edge (edge gateway) to pomost między czujnikiem a chmurą i wykonuje trzy funkcje, bez których cały system by się zapchał. Filtruje szum i redukuje objętość danych przed wysyłką. Buforuje dane lokalnie (store-and-forward), gdy łączność sieciowa pada, więc żaden pomiar nie ginie. I stosuje lokalne reguły alarmowe, dzięki czemu krytyczne ostrzeżenie trafia do operatora w ciągu sekund, a nie po powrocie z rundki przez chmurę.
Komunikacja między warstwami opiera się na kilku sprawdzonych standardach. MQTT dominuje w transmisji danych z czujników dzięki lekkiemu formatowi i niskiemu zużyciu pasma. OPC UA stał się standardem wymiany danych między systemami SCADA, PLC i platformami analitycznymi w środowiskach przemysłowych. Modbus wciąż obsługuje starsze urządzenia i sterowniki, z którymi trzeba się integrować mimo ich wieku. Integracje z konkretnymi kontrolerami PLC pozwalają uruchamiać automatyczne reakcje przy stanach krytycznych bez opóźnień typowych dla przetwarzania w chmurze, co potwierdzają rozwiązania condition monitoring firmy Siemens.
Modele ML i algorytmy: adaptacyjne, ensemble i predykcja RUL
Statyczne modele klasyfikacyjne, trenowane raz i używane bez aktualizacji, systematycznie tracą trafność, bo maszyny zmieniają charakterystykę pracy z wiekiem, obciążeniem i warunkami środowiskowymi. Modele adaptacyjne, które uczą się na bieżąco z napływających danych, radzą sobie z tym problemem znacznie lepiej.
Badanie opublikowane w Scientific Reports porównało modele adaptacyjne z klasycznym podejściem opartym na maszynach wektorów wspierających (SVM) w zastosowaniach przemysłowego IoT.
Przełożone na praktykę fabryczną, taki wzrost oznacza mniej fałszywych alarmów wysyłających mechanika w teren bez powodu oraz mniej przeoczonych awarii, które kosztują znacznie więcej niż niepotrzebna interwencja.
Systemy PdM oparte na IoT zwykle wykonują trzy odrębne zadania analityczne:
- Wykrywanie anomalii identyfikuje odchylenia od normalnego wzorca pracy, zwykle metodami nienadzorowanymi, bo etykietowane przypadki awarii są rzadkie.
- Klasyfikacja usterek przypisuje wykryty problem do konkretnej kategorii (zużycie łożyska, rozbalansowanie, przegrzanie), co pozwala zespołowi UR przygotować właściwe części zamienne z wyprzedzeniem.
- Estymacja RUL szacuje liczbę dni lub cykli pracy do przewidywanej awarii, umożliwiając zaplanowanie interwencji w oknie serwisowym.
Modele ensemble, łączące kilka algorytmów (na przykład lasy losowe z sieciami neuronowymi), radzą sobie lepiej niż pojedynczy model, bo błędy jednego podejścia są korygowane przez inne. Trenowanie wymaga solidnej bazy danych historycznych z etykietowanymi przypadkami awarii, walidacji krzyżowej (cross-validation) sprawdzającej stabilność na różnych podzbiorach danych, oraz mechanizmu ciągłego douczania, bo model wytrenowany na danych z jednego kwartału może nie rozpoznać wzorca sezonowego z innego.
Przeglądy naukowe łączące predictive maintenance IoT z koncepcją przemysłu 5.0 wskazują, że kierunek rozwoju idzie w stronę wyjaśnialności modeli (explainability) i uczenia federacyjnego, co pozwala trenować algorytmy bez przesyłania surowych danych produkcyjnych poza zakład, jak opisuje przegląd systemów AIoT.
Architektura Edge–Cloud i integracja z CMMS, MES i SCADA
Podział zadań między edge a chmurą decyduje o tym, czy system reaguje w sekundach czy w minutach, i ile kosztuje jego utrzymanie. Zła decyzja na tym etapie oznacza albo zbyt wolne reakcje na krytyczne stany, albo rachunki za transfer danych, które rosną szybciej niż budżet UR.
Zasada podziału jest prosta, choć często ignorowana. Na urządzeniu edge zostają szybkie detekcje progowe i filtrowanie danych, bo tam liczy się czas reakcji liczony w milisekundach. W chmurze dzieje się trenowanie modeli, analiza floty maszyn na poziomie całego zakładu czy grupy zakładów, oraz długoterminowe raportowanie trendów. Przegląd architektur AIoT w Sensors opisuje tę współpracę Edge–Cloud jako warunek skalowania predictive maintenance ponad jedną linię produkcyjną bez utraty prywatności danych i bez przeciążania sieci.
Referencyjna architektura opublikowana przez Microsoft pokazuje ten pipeline w praktyce: dane trafiają z czujników w czasie mierzonym w sekundach, przechodzą wzbogacenie kontekstowe (dodanie metadanych produkcyjnych), są oceniane przez model w czasie rzeczywistym, a wynik trafia jako powiadomienie push wprost do technika, jak opisuje architektura referencyjna Microsoft dla predictive maintenance.
Mapowanie predykcji na rzeczywiste zlecenia w CMMS wymaga trzech elementów, które łatwo przeoczyć na etapie projektowania:
- Powiązanie punktu pomiarowego z kartą zasobu w CMMS — każdy czujnik musi być jednoznacznie przypisany do konkretnej maszyny lub podzespołu w systemie utrzymania, inaczej alert trafia w pustkę.
- Reguły progowe generujące zlecenie — nie każda anomalia powinna automatycznie tworzyć zadanie; potrzebny jest próg pewności modelu, poniżej którego alert idzie tylko do przeglądu ręcznego.
- Priorytetyzacja na podstawie krytyczności zasobu — ta sama anomalia na maszynie zapasowej i na wąskim gardle produkcyjnym powinna generować zlecenia o różnym priorytecie.
Typowy scenariusz wygląda tak: model wykrywa wzorzec wskazujący na degradację łożyska, system weryfikuje sygnał względem drugiego niezależnego czujnika (na przykład temperatury), a po potwierdzeniu tworzy zlecenie w CMMS z opisem prawdopodobnej przyczyny i sugerowaną częścią zamienną. Integracja z systemami MES dodaje kontekst produkcyjny, który pozwala odróżnić realną anomalię od normalnego wzrostu wibracji przy zmianie profilu produkcji.
Plan wdrożenia: od audytu przez pilota do skalowania
Najczęstszy błąd przy wdrażaniu predictive maintenance IoT to start od zakupu sprzętu na cały zakład. Skuteczniejsze podejście zaczyna się od jednego, dobrze wybranego pilota.
- Audyt i wybór zasobu pilotażowego. Wybierz maszynę, gdzie koszt nieplanowanego przestoju jest najwyższy i gdzie masz już dostęp do jakichkolwiek danych historycznych o awariach, nawet w formie papierowych raportów UR.
- Instalacja czujników i zbieranie danych bazowych. Ten etap trwa realistycznie 3 do 6 miesięcy, bo model potrzebuje zaobserwować pełny cykl pracy maszyny, włącznie z sezonowymi zmianami obciążenia.
- Trenowanie i walidacja modelu. Data scientist lub dostawca technologii buduje pierwszy model na zebranych danych i testuje go na wydzielonym zbiorze, który nie był używany do treningu.
- Integracja z CMMS i testowe generowanie zleceń. Predykcje trafiają do systemu utrzymania w trybie doradczym, zanim automatycznie zaczną tworzyć zlecenia.
- Ocena wyników i decyzja o skalowaniu. Porównujesz liczbę wykrytych awarii przed katastrofą z liczbą fałszywych alarmów i decydujesz, czy rozszerzyć projekt na kolejne maszyny.
Zespół projektowy powinien obejmować cztery role, których brak jednej regularnie wykoleja projekty: dział utrzymania ruchu (znajomość maszyn i historii awarii), IT (infrastruktura sieciowa i bezpieczeństwo), data scientist lub analityk (budowa i walidacja modeli) oraz dostawca technologii integrujący sprzęt z oprogramowaniem.
Porada profesjonalisty: Nie czekaj z integracją CMMS do końca pilota. Podłącz system utrzymania od pierwszego dnia, nawet jeśli na razie tylko rejestruje surowe alerty bez automatyzacji. Historia tych wczesnych sygnałów staje się cennym materiałem treningowym, kiedy model dojrzeje.
Walidacja pilota powinna opierać się na konkretnych, mierzalnych KPI ustalonych przed startem, nie po fakcie. Liczba prawidłowo wykrytych anomalii potwierdzonych przez mechanika w terenie, liczba fałszywych alarmów na miesiąc i czas między pierwszym ostrzeżeniem a faktyczną awarią to trzy podstawowe wskaźniki, które pozwalają obiektywnie ocenić, czy warto skalować projekt na kolejne linie.
Wyzwania wdrożeniowe: ground truth, fałszywe alarmy i cyberbezpieczeństwo
Model uczenia maszynowego jest tak dobry, jak dane, na których się uczy, a największym praktycznym problemem predictive maintenance IoT nie jest technologia czujników, lecz brak systematycznego ground truth, czyli potwierdzonych informacji o rzeczywistej przyczynie awarii.
Bez tej pętli zwrotnej model nie wie, czy jego predykcja była trafna. Analiza roli ground truth w cyfrowej transformacji utrzymania ruchu opisuje mechanizm, który rozwiązuje ten problem: zlecenie z CMMS trafia do mechanika, mechanik zapisuje faktyczną przyczynę usterki po naprawie, a ta informacja wraca do modelu jako dane treningowe. Bez systematycznego feedbacku z CMMS modele stopniowo tracą skuteczność, bo uczą się na niekompletnym obrazie rzeczywistości.
Statystyka: badanie adaptacyjnych modeli ML w IIoT pokazuje, że modele ciągle douczane na nowych, potwierdzonych danych utrzymują wyższą precyzję i recall niż modele statyczne, co bezpośrednio przekłada się na mniej fałszywych alarmów w długim okresie eksploatacji.
Kilka praktyk minimalizuje najczęstsze przyczyny porażki projektu PdM:
- Kontekstualizuj odczyty czujników danymi produkcyjnymi z MES, bo wzrost wibracji przy zmianie profilu produkcji nie jest awarią, tylko normalną reakcją na inne obciążenie.
- Oddzielaj sieć operacyjną (OT) od sieci IT fizycznie lub logicznie, żeby awaria czy atak w jednej warstwie nie sparaliżował drugiej.
- Szyfruj transmisję między bramą edge a chmurą i wymuszaj uwierzytelnianie urządzeń, bo niezabezpieczony czujnik IoT jest łatwym punktem wejścia do sieci zakładowej.
- Ograniczaj dostęp do danych z czujników według zasady najmniejszego uprzywilejowania, szczególnie gdy dane trafiają do zewnętrznej platformy chmurowej.
Dobrą praktyką jest też stopniowe uwalnianie automatyzacji: najpierw system tylko zgłasza zlecenia niskiego ryzyka bez interwencji człowieka, a wyższe poziomy automatyzacji wchodzą dopiero po potwierdzeniu, że predykcje są konsekwentnie trafne, jak zaleca praktyczny przewodnik po wdrażaniu AI i IoT w utrzymaniu ruchu.
KPI i ROI: jak mierzyć sukces predykcyjnego utrzymania
Trzy wskaźniki decydują o tym, czy zarząd zaakceptuje rozszerzenie budżetu na predictive maintenance IoT, i każdy z nich mierzy inny aspekt efektywności utrzymania ruchu.
MTBF (mean time between failures, średni czas między awariami) rośnie, gdy system wykrywa problemy, zanim doprowadzą do pełnej awarii. MTTR (mean time to repair, średni czas naprawy) spada, bo mechanik przyjeżdża z odpowiednią częścią zamienną, znając wcześniej prawdopodobną przyczynę usterki, zamiast diagnozować problem na miejscu. OEE (overall equipment effectiveness, całkowita efektywność wyposażenia) rośnie jako efekt pochodny obu poprzednich wskaźników, bo mniej nieplanowanych przestojów oznacza więcej czasu produktywnego.
Te liczby pochodzą z case studies dostawców, więc traktuj je jako orientacyjny benchmark, nie gwarancję wyniku we własnym zakładzie.
Przy przygotowaniu biznes case dla zarządu pomaga kilka elementów:
- Policz realny koszt godziny nieplanowanego przestoju konkretnej maszyny, uwzględniając stracone przychody i koszty nadgodzin ekipy naprawczej.
- Porównaj koszt pilota (sprzęt, integracja, czas zespołu) z potencjalną redukcją liczby przestojów w pierwszym roku.
- Pokaż konkretny przykład jednej unikniętej awarii z pilota, bo jedna namacalna historia przekonuje zarząd bardziej niż arkusz kalkulacyjny z prognozami.
Pierwszy wymierny zwrot z inwestycji zwykle pojawia się w ciągu około roku do kilkunastu miesięcy od rozpoczęcia pilota, co potwierdzają praktyczne wdrożenia branżowe. To wystarczający czas, żeby model dojrzał na pełnym cyklu produkcyjnym i żeby integracja z CMMS zaczęła generować rzetelne dane porównawcze.
Case study Synaptix: jak Studio-lokhit wdrożyło monitoring stanu maszyn
Projekt Synaptix Platform pokazuje, jak wygląda predictive maintenance IoT wdrożony w praktyce, nie w teorii. Studio-lokhit zrealizowało pełen zakres prac: od integracji czujników wibracji i temperatury na krytycznych maszynach, przez konfigurację warstwy edge processing filtrującej dane przed wysyłką do chmury, po zbudowanie dashboardów operacyjnych i integrację z systemem CMMS klienta.
Kluczowym elementem projektu było połączenie warstwy technicznej z realną potrzebą biznesową. Zamiast instalować czujniki na wszystkim, zespół zaczął od zmapowania, które zasoby generują najwyższy koszt przestoju, i tam skoncentrował pierwszą fazę wdrożenia. Dashboardy zaprojektowano tak, by operator utrzymania ruchu widział nie tylko surowy odczyt czujnika, ale gotową interpretację: poziom ryzyka, prawdopodobną przyczynę i sugerowany termin interwencji.
Efekt tego podejścia to mierzalna redukcja liczby nieplanowanych przestojów oraz krótszy czas reakcji między pierwszym sygnałem ostrzegawczym a decyzją serwisową, bo informacja trafiała do właściwej osoby automatycznie, zamiast czekać na ręczny przegląd raportów. To dokładnie ten mechanizm, który odróżnia projekt PdM działający realnie od systemu, który zbiera dane, ale nigdy nie zamienia ich w akcję.
Pełny opis architektury technicznej, zastosowanych integracji i wyników projektu znajdziesz w case study Synaptix Platform. Jeśli twój zakład rozważa podobne wdrożenie, ten materiał daje konkretny punkt odniesienia, zanim zaczniesz rozmowy z własnym dostawcą technologii.
Perspektywa autora: co naprawdę decyduje o sukcesie wdrożenia
Największym błędem, jaki widzę powtarzany w projektach PdM, jest kupowanie czujników przed zbudowaniem infrastruktury do zbierania i porządkowania danych. Firma instaluje dziesiątki sensorów, dane wpadają do jednego dużego zbioru bez struktury, a po roku okazuje się, że nikt nie ma pojęcia, który odczyt odpowiada której maszynie w którym momencie procesu produkcyjnego.
Konwencjonalna mądrość mówi, że im więcej danych, tym lepszy model. W praktyce lepszy jest mniejszy, dobrze oznaczony zbiór danych z rzetelnym ground truth niż ogromna hałda nieopisanych pomiarów. Model uczy się z potwierdzonych przypadków, nie z ilości.
Jeśli zaczynasz od zera, zrób trzy rzeczy w tej kolejności: wybierz jeden zasób, gdzie przestój najbardziej boli finansowo, zapewnij, że dane o faktycznych naprawach trafiają z powrotem do systemu, i dopiero potem myśl o skalowaniu na cały zakład. Sukces mierz nie liczbą zainstalowanych czujników, ale liczbą awarii, które zespół UR faktycznie przewidział, zanim doszło do przestoju.
— Mateusz
Jak Studio-lokhit wspiera wdrożenia monitoringu stanu maszyn
Studio-lokhit projektuje i wdraża kompletne systemy IoT dla utrzymania ruchu, od doboru i instalacji czujników przez konfigurację bram edge, po integrację modeli ML z istniejącym CMMS klienta, więc nie musisz szukać osobno dostawcy sprzętu, integratora oprogramowania i analityka danych.
Realizacja projektu Synaptix Platform pokazała, że sukces wdrożenia zależy od jednego: połączenia warstwy technicznej (czujniki, przetwarzanie edge) z realnym procesem decyzyjnym w dziale utrzymania ruchu. Zespół Studio-lokhit projektuje systemy monitorowania stanu tak, by predykcja od razu zamieniała się w konkretne zlecenie, a nie leżała w dashboardzie, na który nikt nie zdąży spojrzeć.
Pełny zakres usług wdrożeniowych IT i integracji systemów obejmuje audyt gotowości zakładu do wdrożenia predictive maintenance, dobór czujników odpowiednich do konkretnego środowiska produkcyjnego oraz konfigurację modeli ML dopasowanych do danych historycznych klienta. Jeśli rozważasz pilota w swoim zakładzie, skontaktuj się ze Studio-lokhit i zapytaj o audyt dojrzałości technologicznej, żeby zobaczyć, od którego zasobu warto zacząć.
Źródła
Dla czytelników chcących zgłębić temat technicznie, badanie adaptacyjnych modeli ML w IIoT opublikowane w Scientific Reports daje solidne dane liczbowe o przewadze modeli adaptacyjnych. Przegląd architektur AIoT w Sensors tłumaczy, jak skalować systemy Edge–Cloud bez przeciążania infrastruktury. Praktyczne wskazówki dotyczące doboru czujników w trudnym środowisku fabrycznym znajdziesz w analizie IIoT World, a rolę ground truth w skuteczności modeli szczegółowo opisuje przewodnik F7i po analizie przyczyn źródłowych.
- Adaptive machine learning models for predictive maintenance in industrial internet of things (IIoT) systems | Scientific Reports
- AIoT-enabled predictive maintenance review | MDPI Sensors
- Microsoft — predictive maintenance reference architecture